فك شفرة معايير الذكاء الاصطناعي: ماذا تخفي المخططات الجديدة؟
تحب شركات الذكاء الاصطناعي التباهي بمخططات ملونة ودرجات هائلة. لكن المقاييس اللوغاريتمية والتكاليف الخفية والبيانات المنتقاة تعني أن هذه المخططات غالباً ما تخفي الحقيقة. إليك كيفية قراءتها.
كل شهر، تطلق إحدى كبرى مختبرات الذكاء الاصطناعي نموذجاً جديداً. وكل شهر، يرافق هذا الإطلاق بيان صحفي يعرض مخططات ملونة، وأرقاماً هائلة، وادعاءات بأداء “متطور” و“غير مسبوق”.
بالنسبة للمطورين والمؤسسين ومديري المنتجات، من المفترض أن تكون هذه المخططات بمثابة البوصلة. من المفترض أن تخبرك بالنموذج الذي يجب استخدامه.
لكنها لا تفعل ذلك.
صُممت مخططات اختبارات الذكاء الاصطناعي الحديثة لتثير الإعجاب، وليس لتقديم المعلومات. فهي تستخدم حيلاً بصرية محددة، وحسابات خفية، وبيانات منتقاة لجعل كل نموذج جديد يبدو وكأنه قفزة هائلة إلى الأمام. إذا كنت تريد اتخاذ القرار الهندسي الصحيح، فأنت بحاجة إلى معرفة كيفية فك شفرتها. ولكن قبل أن نلقي نظرة على الحيل البصرية، من المفيد أن نفهم العيوب الهيكلية الأعمق في كيفية بناء هذه الاختبارات. (يمكنك قراءة تحليلنا الكامل حول لماذا تُعدّ معظم مقاييس أداء الذكاء الاصطناعي مضللة؟ ).
إليك أكبر أربع حيل مخفية في الجيل الجديد من مخططات اختبارات الذكاء الاصطناعي، وكيفية النظر إلى ما هو أبعد منها.
الفخ الأول: وهم “الرقم السحري”
عندما يتم إصدار نموذج جديد، فإن أول ما تراه هو رقم واحد عملاق. قد يُطلق عليه “مؤشر الذكاء”، أو “الدرجة الإجمالية”، أو “تصنيف القدرات”.
ألقِ نظرة على مخطط حديث من موقع رئيسي متخصص في الاختبارات:
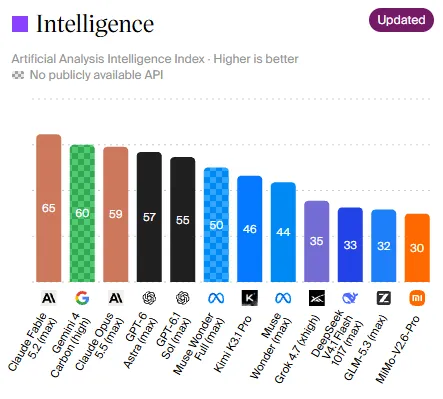
للوهلة الأولى، يبدو أن Claude Fable 5.2 (65) و Gemini 4 Carbon (60) هما النموذجان “الأذكى”، بينما تُرك نماذج مثل MiMo-V2.6-Pro (30) في المؤخرة.
لماذا هذا مضلل؟ الدرجة المركبة الواحدة هي متوسط العشرات من الاختبارات المختلفة (الرياضيات، البرمجة، الاستدلال، الكتابة). الذكاء الاصطناعي الذي يحصل على 65 قد يكون مذهلاً في البرمجة ولكنه فظيع في تحليل البيانات. الذكاء الاصطناعي الذي يحصل على 30 قد يكون أسوأ بكثير في الاستدلال المعقد، لكنه قد يكون مناسباً تماماً لاستخراج البيانات من الفواتير، وقد يكلف أقل بـ 100 مرة.
عندما تنظر إلى رقم واحد، فإنك تفقد الفروق الدقيقة. وتبدأ في نشر حاسوب عملاق للقيام بعمل آلة حاسبة.
الفخ الثاني: وهم المقياس اللوغاريتمي
إذا نظرت إلى مخطط يرسم علاقة “الذكاء مقابل التكلفة”، فغالباً ما ترى أن محور التكلفة (المحور الأفقي) يستخدم مقياساً لوغاريتمياً.
هذه حيلة رياضية تُستخدم لاستيعاب النماذج الرخيصة جداً والنماذج الباهظة جداً على نفس الشاشة. المشكلة هي أن عقول البشر لا تفكر بطريقة لوغاريتمية.
على المخطط اللوغاريتمي، تبدو المسافة بين 0.03 دولار و 0.10 دولار مطابقة تقريباً للمسافة بين 0.10 دولار و 1.00 دولار. لكن 0.10 دولار أغلى ثلاث مرات من 0.03 دولار، بينما 1.00 دولار أغلى عشر مرات من 0.10 دولار.
عندما تضع شركة نموذجها الجديد على مقياس لوغاريتمي، فإنها تقلل بصرياً من الفجوة الهائلة بين نموذج اقتصادي ونموذج متميز. يريدونك أن تعتقد، “الفرق في التكلفة هو مجرد خطوة صغيرة إلى اليمين”، بينما في الواقع، هو هاوية سحيقة.
الفخ الثالث: مفارقة الوقت (الأذكى هو الأبطأ)
لقد تعلمنا أن نعتقد أن “الأذكى” هو دائماً الأفضل. لكن في بيئة الإنتاج، غالباً ما يعني “الأذكى” “الأبطأ”.
انظر إلى هذا المخطط الذي يوضح الوقت لكل مهمة (عدد الدقائق التي يستغرقها النموذج لإكمال مهمة اختبارية):
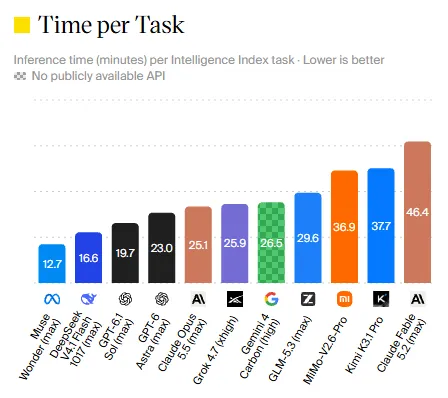
لاحظ أن Claude Fable 5.2 يستغرق أطول وقت (46.4 دقيقة لكل مهمة). لماذا؟ لأنه يستخدم “سلسلة تفكير” ضخمة للاستدلال خلال المشكلة. وفي الوقت نفسه، ينهي Muse Wonder 1.0 المهمة في 12.7 دقيقة فقط.
إذا كنت تبني روبوت دردشة لدعم العملاء، فإن وقت استجابة يبلغ 46 دقيقة هو أمر غير مجدٍ، بغض النظر عن مدى “ذكاء” النموذج. ومع ذلك، تدفن معظم مخططات الإطلاق زمن الاستجابة (الوقت) في الأسفل، وتركز فقط على درجة الذكاء. إذا كان النموذج بطيئاً جداً بحيث لا يمكن استخدامه، فإن ذكائه لا صلة له بالموضوع.
الفخ الرابع: فارق الـ 100 ضعف في التكلفة (وأكاذيب الأسعار المعلنة)
دعونا نلقي نظرة على المخطط الأكثر أهمية: التكلفة لكل مهمة.
بدأت مواقع الاختبارات في حساب التكلفة الفعلية لتشغيل إحدى مهام الاختبار الخاصة بها. هذه خطوة رائعة إلى الأمام، لكنها تكشف عن فجوة مرعبة:
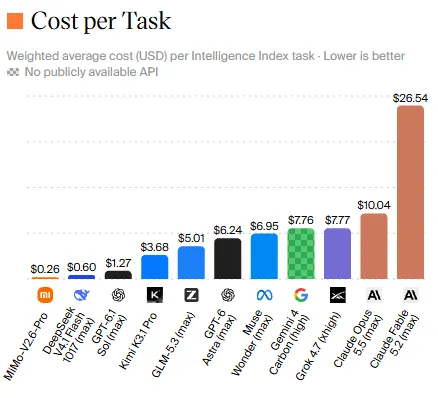
النموذج الأرخص هنا (Mimo-V2.6-Pro) يكلف 0.26 دولار لكل مهمة. أغلى نموذج (Claude Fable 5.2) يكلف 26.54 دولار لكل مهمة. هذا فرق يبلغ 100 ضعف.
لكن انتظر، هناك مشكلة خفية أخرى: السعر المعلن مقابل السعر الحقيقي. غالباً ما تحسب مواقع الاختبارات هذه التكلفة باستخدام أسعار واجهة برمجة التطبيقات الرسمية (السعر المعلن) التي تنشرها OpenAI أو Anthropic. لكن المستخدمين الحقيقيين نادراً ما يدفعون السعر المعلن. فهم يستخدمون التخزين المؤقت (Caching)، أو يستخدمون مزودين خارجيين (مثل OpenRouter)، أو يستخدمون المعالجة المجمعة (Batch processing).
قد يبدو النموذج باهظ الثمن على المخطط، ولكن إذا كان معدل إصابة التخزين المؤقت مرتفعاً، فقد تكون فاتورتك الفعلية أقل بنسبة 80%. وعلى العكس من ذلك، قد يتطلب النموذج الرخيص ثلاث محاولات (ضريبة إعادة المحاولة)، مما يجعله أكثر تكلفة في الواقع من النموذج المتميز. (لفهم الحسابات الكامنة وراء ذلك، اقرأ دليلنا الكامل حول من ينجز المهمة بتكلفة أقل).
الغموض التقني: النجاح الجزئي مقابل النجاح الثنائي
إذا نظرت عن كثب إلى الجداول التفصيلية (مثل الجدول أعلاه)، فسترى درجات تحمل تسميات مثل (partial) و (binary).
على سبيل المثال، في اختبار OSWorld 2.1 (اختبار لمدى جودة استخدام الذكاء الاصطناعي لسطح مكتب الكمبيوتر)، يحصل Muse Ember على 69.5 (partial) ولكن فقط 33.8 (binary).
ماذا يعني هذا؟
- الجزئي (Partial) يعني أن الذكاء الاصطناعي نجح في بعض الخطوات (على سبيل المثال، فتح المتصفح، ونقر على الرابط الصحيح، لكنه فشل في تنزيل الملف).
- الثنائي (Binary) يعني أنه يحصل على 1 فقط إذا أكمل المهمة بأكملها بشكل مثالي.
النموذج الذي يحصل على درجة عالية في الإكمال الجزئي ولكن درجة منخفضة في الإكمال الثنائي هو نموذج يبدو جيداً في العرض التوضيحي ولكنه يفشل في الإنتاج. إنه ينجز نصف المهمة، مما يتطلب تدخل بشري لإكمال الباقي.
كيف تقرأ أي مخطط للاختبارات في 3 خطوات
إذن، كيف تستخدم هذه المخططات دون أن تنخدع؟
الخطوة 1: تجاهل الدرجة الإجمالية، وابحث عن عمودك. هل تحتاج إلى البرمجة؟ انظر فقط إلى عمود البرمجة. هل تحتاج إلى استخراج المستندات؟ انظر إلى عمود تحليل البيانات. تجاهل الرقم المركب الكبير في الأعلى.
الخطوة 2: ابحث عن التكلفة والوقت الحقيقيين. ابحث عن المخططات التي تعرض “التكلفة لكل مهمة” (وليس فقط السعر لكل مليون توكن). وتحقق من “الوقت لكل مهمة”. النموذج الأذكى بنسبة 2% ولكنه أغلى 10 أضعاف وأبطأ 5 أضعاف هو عادة الخيار الخاطئ. (إذا لم تكن متأكداً من كيفية حساب ذلك لميزانيتك، فإن مقالتنا حول حساب التكلفة الحقيقية للذكاء الاصطناعي تشرح الإطار بالكامل).
الخطوة 3: طالب بالشفافية. قبل أن تثق بأي مخطط، اسأل:
- هل مجموعة الاختبار عامة؟
- من مول هذا الاختبار؟
- هل نشروا درجات منافسيهم، أم درجاتهم فقط؟
الخلاصة
مخططات الاختبارات ليست وثائق علمية. إنها أدوات تسويقية مصممة لجعلك تشتري أحدث وأغلى نموذج.
في NeuralRating، نبني اختبارات مصممة بشكل مختلف. نحن لا نؤمن بـ “الأرقام السحرية” الفردية. نحن نؤمن بإظهار التكلفة الحقيقية لكل مهمة ناجحة، والوقت الذي تستغرقه، وأنماط الفشل الدقيقة، حتى تتمكن من اختيار النموذج الذي يناسب سير عملك فعلاً، وليس النموذج الذي يملك أجمل مخطط.
إذا كنت ترغب في متابعتنا، يمكنك الانضمام إلى قائمة الانتظار في صفحتنا الرئيسية، أو قراءة المزيد عن نهجنا، أو استكشاف المزيد من الرؤى.
الأسئلة الشائعة
ما هو مؤشر الذكاء (Intelligence Index)؟
مؤشر الذكاء هو درجة واحدة يتم إنشاؤها عبر تجميع نتائج العديد من الاختبارات المختلفة. ورغم أنه مفيد كمؤشر عام، إلا أنه يخفي حقيقة أن النموذج قد يكون ممتازاً في البرمجة وضعيفاً في الاستدلال، أو العكس. إنه يخلق وهماً زائفاً بالتفوق الشامل.
لماذا تستخدم مخططات المعايير المقياس اللوغاريتمي؟
غالباً ما يُستخدم المقياس اللوغاريتمي لاستيعاب النماذج التي تكلف 0.03 دولار بجوار النماذج التي تكلف 27 دولاراً في نفس المخطط البصري. ومع ذلك، فإن الجانب السلبي هو أن الفرق البصري بين 0.03 دولار و 0.10 دولار يبدو ضئيلاً، مما يخفي حقيقة أن أحدهما أغلى بأكثر من ثلاثة أضعاف من الآخر.
ما هو الانتقاء (Cherry-picking) في اختبارات الذكاء الاصطناعي؟
الانتقاء هو عندما تبرز الشركة اختباراً معيناً يتفوق فيه نموذجها، بينما تتجاهل أو تخفي الاختبارات التي يتفوق فيها المنافسون. المثال الأبرز هو نموذج Llama 4 من Meta، الذي تم ضبطه خصيصاً للوحة صدارة معينة، ليحتل المركز الثاني اصطناعياً، لكنه هبط إلى المركز 32 عندما تم إصدار النسخة العامة.
ما هو الفرق بين الدرجات الجزئية (partial) والثنائية (binary)؟
في اختبارات مثل OSWorld، تعني الدرجة 'الجزئية' أن الذكاء الاصطناعي أكمل بنجاح بعض خطوات المهمة (مثل فتح ملف لكنه فشل في حفظه). الدرجة 'الثنائية' تعني النجاح أو الفشل: لا تُحتسب إلا إذا اكتملت المهمة بأكملها بشكل مثالي. قد يحصل النموذج على درجة عالية في الإكمال الجزئي لكنه فظيع في الإكمال الثنائي.
كيف أختار نموذجاً إذا كنت لا أستطيع الوثوق بالمخططات؟
تجاهل الدرجة الإجمالية المركبة وانظر فقط إلى العمود المحدد الذي يهم سير عملك. قارن 'التكلفة لكل مهمة' إلى جانب 'الوقت لكل مهمة'. والأهم من ذلك، اختبر أفضل المرشحين على بياناتك الخاصة، لأن لا يوجد اختبار عام يعرف احتياجات عملك المحددة.