نماذج الذكاء الاصطناعي: من ينجز العمل بتكلفة أقل؟
النموذج الأرخص لكل توكن هو غالباً الأغلى في الإنتاج. إليك الحسابات الحقيقية لتكلفة الذكاء الاصطناعي: ضريبة إعادة المحاولة، وفخاخ الفواتير الخفية، والمقياس الوحيد الذي يهم فعلاً.
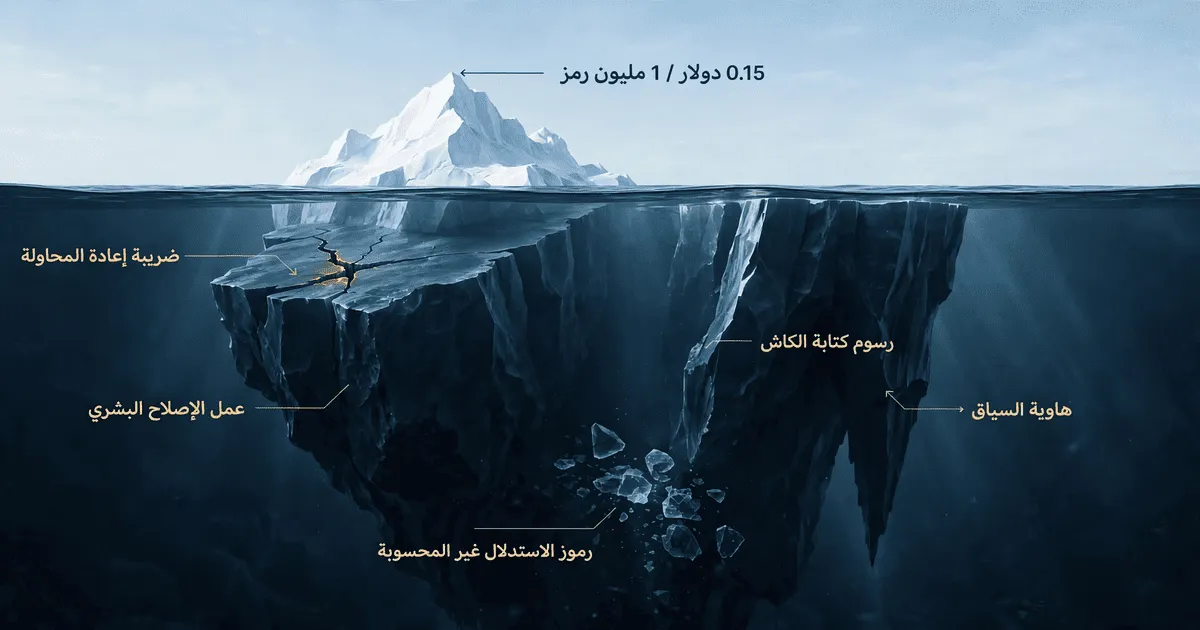
كل نموذج ذكاء اصطناعي تستخدمه، سواء كان GPT أو Gemini أو Claude أو Qwen أو DeepSeek، يُباع ويُسوّق بناءً على سعر التوكن. ولكنك في الواقع تدفع مقابل التكلفة لكل مهمة ناجحة. هذان الرقمان ليسا متطابقين، والفجوة بينهما هي المكان الذي تنزف فيه ميزانيات الذكاء الاصطناعي بصمت.
السبب بسيط: سعر التوكن هو مقياس للبنية التحتية، بينما التكلفة لكل مهمة ناجحة هي مقياس للأعمال. الأول يظهر في فاتورة واجهة برمجة التطبيقات (API)، والثاني يظهر في كشف رواتب موظفيك، وفي تأخير منتجك، وفي ساعات العمل الهندسية التي تُهدر في إصلاح ما أخطأ فيه النموذج.
يشرح هذا المقال لماذا يكون النموذج الأرخص على صفحة الأسعار هو غالباً الأغلى في بيئة الإنتاج، وكيف تحسب الرقم الذي يهم فعلاً.
وهم سعر التوكن
عندما يُطلق نموذج جديد، فإن أول رقم يبحث عنه الجميع هو سعر المليون توكن. إنه رقم بسيط، وقابل للمقارنة، ويُقدَّم وكأنه يحسم مسألة كفاءة التكلفة بمفرده.
لكنه لا يفعل ذلك.
النموذج الذي يتقاضى 0.15 دولار لكل مليون توكن قد يستهلك أربعة أضعاف السياق الذي يستهلكه نموذج يتقاضى 0.60 دولار. النموذج الذي يبدو رخيصاً قد يحتاج إلى ثلاث محاولات لإنتاج مخرجات قابلة للاستخدام. والنموذج الذي يبدو باهظ الثمن قد ينجح من المحاولة الأولى، في كل مرة.
يمكن أن يكون لنموذجين سلوك مختلف تماماً حتى لو ظهرا متقاربين في اختبارات الجودة. قد ينتج أحدهما إجابات قصيرة ومباشرة، بينما يولد الآخر سلاسل طويلة من التفكير، ويعيد محاولة المهام الفرعية، أو يضيع في المهام المعقدة. في بيئات العمل الهندسية والوكلاء الآليين، حيث تكرر النماذج، وتخطط، وتستدعي الأدوات، وتتعامل مع مهام متعددة الخطوات، يمكن أن يتباين استهلاك التوكنات بشكل هائل.
سعر التوكن يخبرك بما يتقاضاه المزود مقابل وحدة نصية واحدة. لكنه لا يخبرك بشيء عن عدد الوحدات التي سيحرقها النموذج لإنهاء عملك.
التكلفة الحقيقية للمحاولة الواحدة
إجمالي تكلفة الملكية (TCO) لمحاولة واحدة في مهمة ما يتكون من ثلاثة عناصر:
TCO = C_token + P(fail) × L
- C_token: تكلفة التوكن للمحاولة الواحدة.
- P(fail): احتمال أن تتطلب المخرجات تدخلاً بشرياً (ألا يعمل الكود، أو أن تنكسر بنية البيانات، أو أن يختلق النموذج قيمة).
- L: التكلفة الكاملة لإصلاح الخطأ بشرياً (أجر الساعة × وقت الإصلاح).
النموذج الرخيص يقلل من العنصر الأول ويضخم العنصر الثاني بصمت. الأول يظهر في فاتورة واجهة برمجة التطبيقات، والثاني يظهر في كشف الرواتب.
هذا ليس تمريناً نظرياً. فكر في نموذجين يعملان على طلب معقد:
| النموذج الاقتصادي | النموذج المتقدم | |
|---|---|---|
| تكلفة التوكن للمحاولة | 0.08 دولار | 1.04 دولار |
| نسبة الفشل | 45% | 8% |
| تكلفة الإصلاح البشري | 75 دولاراً | 75 دولاراً |
| إجمالي التكلفة المتوقعة | 33.83 دولاراً | 7.04 دولارات |
على الرغم من أن تكلفته لكل توكن تزيد 13 ضعفاً، فإن النموذج المتقدم أرخص بـ 4.8 أضعاف لكل مهمة مكتملة. التوفير لم يختفِ، بل انتقل من فاتورة الـ API إلى بند الرواتب.
ضريبة إعادة المحاولة: التكلفة الحقيقية للفشل
ضريبة إعادة المحاولة هي الإنفاق الإضافي الناتج عن حاجة النموذج إلى محاولات متعددة لإنهاء مهمة واحدة. وهي الطريقة العملية الأكثر تعبيراً عن عدم الكفاءة الخفي في سير عمل الوكلاء.
الحسابات واضحة. إذا كان النموذج ينجح باحتمال p، فإن متوسط عدد المحاولات للوصول إلى نجاح واحد هو 1/p.
| نسبة النجاح | المحاولات المتوقعة | ضريبة إعادة المحاولة مقارنة بـ 91% |
|---|---|---|
| 91% | 1.10 تقريباً | 1.0x (خط الأساس) |
| 80% | 1.25 | +14% |
| 66% | 1.52 | +38% |
| 50% | 2.00 | 1.8x تقريباً |
| 39% | 2.56 | 2.3x تقريباً |
| 20% | 5.00 | 4.5x تقريباً |
لاحظ شكل المنحنى. الانخفاض من 91% إلى 80% يضيف فقط ضريبة بنسبة 14%. ولكن المنحنى يرتفع بشكل حاد بمجرد أن تهبط تحت 50%. النموذج الذي ينجح بنسبة 20% من الوقت يحتاج إلى حوالي 4.5 أضعاف استدعاءات الأدوات لإنتاج نفس النتيجة التي ينتجها نموذج ينجح بنسبة 91%.
وهذه المعادلة هي الحد الأدنى. فكل إعادة محاولة تحمل استجابة الخطأ الكاملة مرة أخرى في السياق، وتضيف جولة للغة النموذج لتحليل السبب، وتضخم سجل المحادثة لكل جولة لاحقة. ضريبة إعادة المحاولة الحقيقية تتراكم عبر حجم التوكنات، وعدد الاستدعاءات، والوقت الفعلي المستغرق.
ست فخاخ خفية في الفاتورة لا تظهرها قائمة الأسعار
حتى لو وضعت في حسبانك إعادة المحاولة والإصلاح البشري، فإن سعر التوكن لا يزال ليس القصة الكاملة. هناك ست آليات للفوترة تفصل بين قائمة الأسعار وفاتورتك، وكل واحدة منها قادرة على تحريك الفاتورة أكثر من تغييرك لمزود الخدمة.
1. عدم تناسق التخزين المؤقت (Cache Asymmetry): يُسوَّق التخزين المؤقت على أنه خصم، لكن نصفه فقط كذلك. في نماذج Anthropic، تكلف كتابة التخزين المؤقت 1.25 ضعف سعر الإدخال الأساسي، بينما تكلف قراءته 0.1 ضعف. إذا كتبت في التخزين المؤقت ولم تقرأ منه أبداً، فأنت ببساطة دفعت 25% إضافية. وقد تبنّت OpenAI نفس الشكل في إصداراتها اللاحقة.
2. الفوترة حسب أوقات الذروة: تفرض بعض الشركات أسعاراً مختلفة لنفس عبء العمل في أوقات مختلفة من اليوم. نموذج التكلفة الذي بُني قبل تغيير الأسعار قد يكون خاطئاً بمعامل مضاعف، وليس بنسبة مئوية.
3. جرف السياق (Context Cliffs): بعض النماذج لها حد أقصى صارم، وبعده يتم محاسبة كل توكن في الطلب بسعر أعلى. الطلب الذي يحتوي على 201 ألف توكن لا يكلف أكثر بقليل من 199 ألف توكن، بل يكلف ضعف السعر.
4. توكنات الاستدلال غير المحسوبة: تولد بعض النماذج توكنات تفكير قبل الإجابة. هذه التوكنات تُحاسب عليها كإخراج، لكنها لا تظهر أبداً في الاستجابة المرئية. الإجابة القصيرة على سؤال صعب قد تنتج فاتورة إخراج كبيرة.
5. رسوم المنصات الوسيطة: قد تفرض المنصات المجمعة نسبة مئوية على عمليات تعبئة الرصيد، بالإضافة إلى مكون ثابت لكل معاملة. الرسوم ليست زيادة على سعر التوكن، لكنها لا تزال تكلفة لا تظهر في قائمة أسعار المزود.
6. حسابات الاشتراكات الشهرية: يحول الاشتراك الشهري الثابت التكلفة المتغيرة إلى تكلفة ثابتة، ولكنه يحول أيضاً مشكلة إنفاق إلى مشكلة توفر. عندما تنفد حصة الاستخدام، تتوقف عن العمل بدلاً من أن تدفع المزيد.
ما الذي يجب قياسه بدلاً من ذلك
المقياس الذي يهم هو التكلفة لكل مهمة ناجحة. إنه إجمالي الإنفاق عبر كل المحاولات، بما في ذلك إعادة المحاولة، وفشل استدعاء الأدوات، والمحاولات المهجورة، والمراجعة البشرية، مقسوماً على عدد المهام التي اكتملت بنجاح.
أجرت شركة Arize بالتعاون مع Fireworks اختبارات على 10 نماذج عبر 2400 عملية تشغيل للوكلاء. وكانت النتائج صريحة: التصنيفات “مفتوح” و“مغلق”، و“رخيص” و“غالي” كانت المحور الخاطئ. ما ميز النماذج هو التكلفة لكل مهمة ناجحة. نموذج مفتوح بنسبة نجاح 33% كلف 0.054 دولار لكل مهمة ناجحة مع ضريبة إعادة محاولة تبلغ 3.0 أضعاف، بينما كلف نموذج متقدم بنسبة نجاح 67% ما قيمته 0.636 دولار لكل مهمة ناجحة، لكنه حمل ضريبة إعادة محاولة تبلغ 1.5 ضعف فقط. أرخص سعر معلن لم ينتج أرخص عملاً مكتملاً.
بالنسبة لفرق الإنتاج، يجب أن يشمل إطار التقييم ما يلي:
- تكلفة إنجاز المهمة: إجمالي الإنفاق للوصول إلى نتيجة ناجحة.
- نسبة النجاح: مدى موثوقية النموذج في حل المهمة.
- كفاءة التوكن: مقدار السياق الذي يستهلكه النموذج على طول الطريق.
- سلوك الفشل: ما إذا كان النموذج يدخل في حلقات مفرغة، أو يفرط في التفكير، أو يتطلب إعادة محاولة.
- الملاءمة التشغيلية: مدى نجاحه داخل المطالبات والأدوات وسير العمل الحقيقية.
التوجيه حسب التعقيد، وليس السعر
البنية المثلى ليست اختيار نموذج واحد، بل توجيه كل طلب حسب تعقيده.
وجّه الأعمال الروتينية (مثل عمليات الإنشاء والقراءة والتحديث والحذف، وتوليد لغة SQL، والاستخراج، والتصنيف) إلى النموذج الأرخص، حيث يظل احتمال الفشل وتكلفة الإصلاح منخفضين.
وجّه عمليات الاندماج الغامضة، وتصميم الأنظمة، والتخطيط المعماري، والاستدلال الصعب إلى النموذج المتقدم، حيث إن منع خطأ هندسي واحد مكلف يغطي بسهولة تكلفة التوكن الإضافية.
استخدام نموذج باهظ لمهمة بسيطة يهدر ميزانية الـ API. واستخدام نموذج رخيص لمهمة معمارية يهدر وقت المهندسين. واحدة فقط من هاتين التكلفتين تظهر في فاتورة السحابة. والأخرى تظهر في المواعيد النهائية الفائتة، وإعادة العمل، والتآكل الصامت للثقة في النظام.
الخلاصة
سعر التوكن هو ما تُحاسب عليه. التكلفة لكل مهمة ناجحة هي ما تدفعه فعلاً.
أرخص نموذج على صفحة الأسعار ليس أرخص نموذج في الإنتاج. النموذج ذو السعر الأقل لكل توكن ليس النموذج الذي ينهي المهمة بأقل تكلفة إجمالية. الرقم الذي يهم هو ذلك الذي يتضمن إعادة المحاولة، وآليات الفوترة الخفية، والوقت البشري المطلوب لتحويل مخرجات النموذج إلى عمل مكتمل فعلاً.
في NeuralRating، نبني اختبارات التكلفة لدينا حول التكلفة لكل مهمة ناجحة، وليس سعر التوكن. لأن الاختبار الذي يتجاهل تكلفة الفشل لا يقيس ما تدفعه أنت، بل يقيس ما يريد المزود أن تراه.
إذا كنت ترغب في متابعتنا، يمكنك الانضمام إلى قائمة الانتظار في صفحتنا الرئيسية، أو قراءة المزيد عن نهجنا، أو استكشاف المزيد من الرؤى.
الأسئلة الشائعة
لماذا يعد سعر التوكن مقياساً مضللاً؟
سعر التوكن يخبرك فقط بما يتقاضاه المزود مقابل وحدة نصية واحدة. لكنه لا يخبرك بعدد الوحدات التي سيستهلكها النموذج، ولا بعدد المرات التي سيفشل فيها ويحتاج إلى إعادة محاولة، ولا بمقدار الوقت البشري الذي ستستهلكه أخطاؤه. النموذج الرخيص لكل توكن قد يحتاج إلى ثلاث محاولات وإصلاح بشري، مما يجعله أغلى بكثير من نموذج ينجح من المحاولة الأولى.
ما هي ضريبة إعادة المحاولة في الذكاء الاصطناعي؟
ضريبة إعادة المحاولة هي التكلفة الإضافية الناتجة عن حاجة النموذج إلى محاولات متعددة لإنجاز مهمة واحدة. إذا كان النموذج ينجح بنسبة 80%، فإن متوسط عدد المحاولات المطلوبة هو 1.25، مما يعني أنك تدفع 14% إضافية في المتوسط. وإذا انخفضت نسبة النجاح إلى أقل من 50%، فإن هذه الضريبة ترتفع بشكل حاد.
ما هي التكاليف الخفية في فواتير واجهات برمجة تطبيقات النماذج اللغوية؟
بعيداً عن السعر المعلن لكل توكن، تفرض الشركات رسوماً على كتابة التخزين المؤقت (غالباً 1.25 ضعف سعر الإدخال)، وتطبق ما يسمى بـ 'جرف السياق' الذي قد يضاعف تكلفة الطلب بأكمله إذا تجاوز حداً معيناً من التوكنات، وقد لا تدرج 'توكنات الاستدلال' في عدد المخرجات المرئية. هذه الآليات قد ترفع فاتورتك أكثر من تغييرك لمزود الخدمة نفسه.
ما هو المقياس الصحيح لمقارنة تكاليف نماذج الذكاء الاصطناعي؟
التكلفة لكل مهمة ناجحة. هذا هو إجمالي الإنفاق عبر كل المحاولات، بما في ذلك إعادة المحاولة، وفشل استدعاء الأدوات، والمحاولات المهجورة، مقسوماً على عدد المهام التي اكتملت بنجاح. إنه المقياس الوحيد الذي يعكس ما تدفعه فعلاً مقابل عمل تم إنجازه.
هل يجب أن أستخدم النموذج الأرخص لكل شيء؟
لا. الاستراتيجية المثلى هي التوجيه حسب التعقيد. استخدم النماذج الرخيصة للأعمال الروتينية حيث يكون الفشل رخيصاً ونادراً (مثل الاستخراج، والتصنيف، والتوليد البسيط)، واستخدم النماذج المتقدمة للمهام التي يكون فيها الخطأ الواحد مكلفاً جداً للإصلاح (مثل التخطيط المعماري، وتصميم الأنظمة، والاستدلال المعقد).