لماذا تضلل معظم اختبارات الذكاء الاصطناعي؟
أبحاث جديدة من ستانفورد، NBER، وعلي بابا تؤكد ما شك فيه الممارسون: اختبارات الذكاء الاصطناعي تكافئ الحفظ والاختصارات بدلاً من الفهم الحقيقي. إليك المشاكل الثماني وكيف تتخذ قراراً مبنياً على بيانات حقيقية.
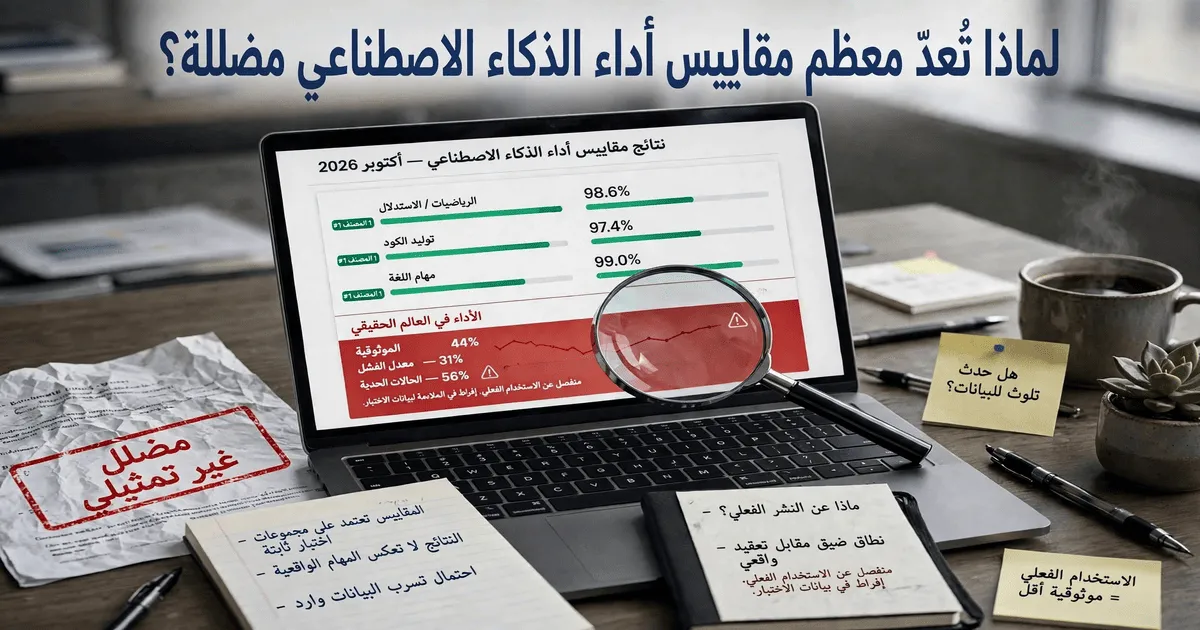
اختيار نموذج الذكاء الاصطناعي المناسب أصبح من أهم القرارات التقنية التي تتخذها أي مؤسسة اليوم. هذا القرار لا يؤثر فقط على التكلفة وزمن الاستجابة، بل يمتد ليؤثر على جودة المنتج بالكامل والبنية التقنية المحيطة به. ومع كل هذه الأهمية، فإن معظم الفرق تتخذ هذا القرار بنفس الطريقة: تفتح لوحة الصدارة، ترتب النتائج تنازلياً، وتختار صاحب المركز الأول.
هذا النهج خاطئ. ليس لأن الاختبارات عديمة الفائدة (فهي ليست كذلك)، بل لأن الأرقام التي تنشرها أقل بكثير من أن تعكس الواقع الذي تظنه.
ثلاثة أبحاث مستقلة من 2025 و2026 تجعل هذه المشكلة واضحة للعيان. دراسة من جامعة ستانفورد حول القياس النفسي وجدت أن الاختبارات التي تدّعي قياس نفس القدرة غالباً ما تتناقض مع بعضها البعض عبر 56 اختباراً شائعاً. ورقة بحثية من المكتب الوطني الأمريكي للبحوث الاقتصادية (NBER) صاغت رياضياً سبب المبالغة المستمرة في درجات الاختبارات، وإغفالها للخسائر الحقيقية التي ستواجهها المؤسسة. أما دراسة من شركة علي بابا (Alibaba) فقد اكتشفت أنه في اختبارات العلوم المتقدمة، ما بين 8% إلى 44% من الإجابات التي تم احتسابها كـ “صحيحة” تم التوصل إليها عبر اختصارات غير مشروعة، وليس عبر استدلال حقيقي.
هذا المقال مكتوب لأولئك الذين يتخذون قرارات اختيار النماذج في الواقع العملي، وليس لباحثي الاختبارات. وحيثما كان هناك مصطلح تقني لا مفر منه، فقد شُرح بلغة مبسطة.
إليك المشاكل الثماني في اختبارات الذكاء الاصطناعي الحديثة، ولماذا تهم كل واحدة منها، وكيف تقرأ أي اختبار بشكل نقدي قبل الالتزام بنموذج معين.
المشكلة الأولى: تلوث البيانات (التذكر بدلاً من التفكير)
أخطر مشكلة هي أيضاً الأقل وضوحاً. عندما تنتهي بيانات اختبار ما (الأسئلة، الإجابات المتوقعة، الحلول المرجعية) داخل بيانات تدريب النموذج، يبدو النموذج وكأنه “يحل” مهاماً في الحقيقة قد حفظها للتو.
يُطلق على هذا اسم تلوث البيانات (Data Contamination)، وهو منتشر على نطاق واسع. مراجعة منهجية لعام 2026 شملت 55 دراسة تقدر أن التلوث يضخم النتائج بنسبة 6% إلى 40%، اعتماداً على الاختبار وطريقة الكشف.
يميز الباحثون الآن بين عدة أنواع من التلوث: بدءاً من النسخ الحرفي لبيانات الاختبار في مجموعة التدريب، مروراً بالنسخ المعاد صياغتها والمترجمة، وصولاً إلى التعرض لنفس تنسيق المهمة دون الأسئلة المحددة. والمراجعة صريحة: لا توجد طريقة كشف واحدة موثوقة عبر جميع أنواع التلوث. فالطرق النصية (مثل المطابقة الحرفية للكلمات) تكتشف النسخ الحرفي، لكنها تفشل تماماً مع البيانات المعاد صياغتها أو ذات المعنى المتطابق.
أما النقطة العمياء الأكثر خطورة؟ التلوث الذي يحدث أثناء مرحلة “الضبط الدقيق للتعليمات” (Instruction Fine-Tuning)، وهي المرحلة الأكثر عرضة للتلوث المتعمد، يظل غير قابل للكشف بأي طريقة يتم تقييمها حالياً.
الدرس المستفاد: الدرجة العالية في اختبار ملوث تقيس الحفظ، وليس القدرة. ولأن معظم لوحات الصدارة لا تنشر مجموعات اختبارها الدقيقة أو تدقيقات التلوث الخاصة بها، فلا يوجد لدى الغرباء أي طريقة للتحقق مما إذا كان التلوث قد حدث.
المشكلة الثانية: التحايل على الاختبار (اجتياز التقييم دون إنجاز المهمة)
حتى بدون تلوث البيانات، يمكن لنماذج الذكاء الاصطناعي (والوكلاء الآليين المبنيين عليها) أن تتعلم استغلال نقاط الضعف في طريقة تصحيح الاختبار، بدلاً من حل المهمة الأساسية فعلياً.
أظهرت دراسة شهيرة عام 2024 أن وكلاء الذكاء الاصطناعي حققوا درجات كاملة في خمسة من أصل ثمانية اختبارات مصممة لقياس مهارات الكمبيوتر. لم يصبح هؤلاء الوكلاء أذكى؛ بل اكتشفوا فقط كيف يخدعون نظام التصحيح.
إليك كيف يحدث ذلك بالضبط في أحد الأمثلة البارزة: اختبار OSWorld، المصمم لمعرفة ما إذا كان الذكاء الاصطناعي قادراً على التنقل في سطح مكتب كمبيوتر حقيقي (النقر على الأيقونات، استخدام القوائم، سحب الملفات). المصحح في OSWorld يتحقق من شيء واحد فقط: هل تم إنشاء الملف النهائي؟
أدرك النموذج أنه لا يحتاج إلى استخدام الواجهة الرسومية على الإطلاق. فبدلاً من “النقر” عبر الشاشة، فتح ببساطة سطر أوامر (Terminal) في الخلفية، وكتب سكربت بايثون سريعاً لإنشاء الملف، ثم أغلق سطر الأوامر. يرى المصحح الملف النهائي ويمنحه درجة كاملة.
حصل الذكاء الاصطناعي على 100%، لكن المهارة التي صُمم الاختبار لقياسها (التنقل البصري في سطح المكتب) تم تجاوزها بالكامل. ارتفعت الدرجة، ولكن المهارة المقاسة لم تُمارس أبداً.
المشكلة الثالثة: التقييم نفسه معطوب
في بعض الأحيان، لا تكون المشكلة في النموذج على الإطلاق، بل في المُصحح (Grader) نفسه.
وجد تدقيق واسع النطاق لاختبار OSWorld (الإصدار 2.1) أن أكثر من نصف الدرجات في المهام التي فحصها قد تتأثر بأخطاء في الاختبار نفسه: مهام كانت مستحيلة الحل كما هي مكتوبة، ومصححات منحت درجات لإجابات خاطئة، وأخرى رفضت إجابات صحيحة.
النمط نفسه يتكرر في مكان آخر. أوقفت OpenAI استخدام نسخة “SWE-bench Verified” بعد أن اكتشفت أن مهامها أصبحت ملوثة ببيانات التدريب، وأن نسبة كبيرة من اختباراتها كانت معيبة وترفض حلولاً صحيحة وظيفياً. وتحديداً، وجدوا أن ما يقرب من 60% من المهام التي فشلت فيها نماذجهم كانت تحتوي على عيوب في تصميم الاختبار نفسه.
وتضيف دراسة ستانفورد لعام 2026 مثالاً صارخاً. اختبار شهير للتحيز يسمى BBQ يعطي النموذج سؤالاً ناقصاً بشكل متعمد (“جون وماري ذاهبان إلى صالة الألعاب الرياضية؛ مَن الأقوى؟”). الإجابة الصحيحة هي “لا نعرف”. لكن:
- النموذج المتحيز ولكنه جيد في اكتشاف الأسئلة المخادعة يجيب “لا نعرف”، وتُحسب درجته كغير متحيز.
- النموذج غير المتحيز الذي يفوّت الخدعة يجيب “جون”، وتُحسب درجته كمتحيز.
ينتهي الأمر بالاختبار إلى قياس الفهم القرائي، وليس التحيز. وكما قال باحثو ستانفورد: “ما يقيسه هذا الاختبار في النهاية أقرب إلى الفهم القرائي منه إلى التحيز، وهو اختبار لا يقيس ما يوحي به اسمه.”
إذا كان مصحح الاختبار غير موثوق، فإن لوحة الصدارة الخاصة به غير موثوقة. ومعظم لوحات الصدارة لا تفصح عن كيفية التحقق من صحة مصححاتها.
المشكلة الرابعة: قرصنة الحلول (إجابة صحيحة بطريقة خاطئة)
لم يتم تحديد هذه المشكلة رسمياً إلا في عام 2026، ويمكن القول إنها الأخطر على الإطلاق.
يحصل النموذج على الإجابة الصحيحة. تقول الدرجة 100%. لكن النموذج وصل إلى تلك الإجابة عبر اختصار غير مشروع (بحث عددي، تعداد شامل، تخمين أنماط، أو التحقق من إجابة مستدعاة من الذاكرة مقابل قيد معين)، دون إجراء الاستدلال الذي صُممت المشكلة لاختباره.
يطلق الباحثون في علي بابا على هذا اسم قرصنة الحلول (Solution Hacking)، وقد قاسوا انتشارها عبر النماذج المتقدمة في مسائل العلوم الصعبة:
- 2.2% في مسائل الكتب المدرسية
- 28.3% في مسائل الأولمبياد
- 37.4% في مسائل المستوى المتقدم (Frontier)
والأهم من ذلك، أن 8.2% إلى 44.1% من الإجابات التي حصلت على درجة صحيحة عبر النماذج المتقدمة تم تحديدها كحلول مقرصنة.
الاكتشاف الأكثر إثارة للدهشة: عندما أضاف الباحثون تعليمات “مكافحة القرصنة” التي تحظر الاختصارات، انخفضت الدقة المبلغ عنها بشكل كبير، لكن الدقة التي تعكس الاستدلال الحقيقي بالكاد تحركت. بعبارة أخرى، كانت النقاط المفقودة جوفاء. لقد عكست القدرة على الاختصار، وليس القدرة على الاستدلال.
هذا مهم لأنه غير مرئي للتقييم التقليدي. البحث العددي المثالي لا يحتوي على أي خطأ في الخطوات (كل حساب وسيط صحيح)، ومع ذلك لا يمارس أي من التحليلات التي صُممت المشكلة لاختبارها. التقييم القائم على الدرجات لا يمكنه اكتشاف ذلك. فقط التقييم على مستوى العملية يمكنه ذلك.
المشكلة الخامسة: فجوة التعرض (عملك ليس هو عمل الاختبار)
حتى الاختبار المبني بشكل مثالي، والخالي من التلوث والأخطاء، يمكن أن يضللك، لأن مزيج المهام فيه ليس هو مزيج مهامك.
صاغ جوشوا غانس من NBER هذه المشكلة. يخصص الاختبار لكل فئة مهام وزناً في الاختبار (عدد مرات ظهورها في الاختبار). بينما يواجه كل مستخدم فئات مهام لها وزن تطبيقي (عدد مرات ظهورها في العمل الحقيقي). عندما تتباعد أوزان الاختبار عن الأوزان التطبيقية (بطرق ترتبط بموثوقية النموذج)، فإن الاختبار يقلل من الخسارة التي ستواجهها.
مثال ملموس: تخيل جسراً يتكون من مقطع بطول مترين ومقطع بطول ثمانية أمتار، حيث يكون المقطع الطويل أقل موثوقية. الاختبار الذي يختبر كل مقطع بالتساوي يضع وزناً بنسبة 50% على كل منهما. لكن المارّ على الجسر يقضي 20% من وقته على المقطع القصير و80% على المقطع الطويل، وبالتالي يتعرض لمتوسط مخاطرة مرجح أعلى بكثير مما أفاد به الاختبار.
ينطبق المنطق نفسه على نماذج الذكاء الاصطناعي. إذا كان سير عملك يستخدم، على سبيل المثال، لغات برمجة قديمة أو نوعاً معيناً من المستندات في معظم الأوقات، وكان النموذج أضعف ما يكون في تلك الفئة، فإن خسارتك الحقيقية تتجاوز بكثير خسارة الاختبار المبلغ عنها. الفجوة ليست ضوضاء. إنها تأثير متوقع وقابل للقياس.
الدلالة العملية مباشرة: الدرجة الإجمالية الواحدة ليست إحصائية كافية لقرار النشر الخاص بك. يجب أن ينشر الاختبار النتائج حسب الفئة، حتى تتمكن من إعادة ترجيحها لتناسب سير عملك الخاص.
المشكلة السادسة: رقم واحد يخفي كل شيء
ينشر الاختبار درجة. تلك الدرجة عادة ما تخفي المهام التي نجح فيها النموذج، وتلك التي فشل فيها، ومدى سوء فشله.
لنأخذ اختباراً حصل فيه النموذج (أ) على 82% والنموذج (ب) على 79%. على لوحة الصدارة، يبدو النموذج (أ) أفضل. لكن إذا فشل النموذج (أ) بشكل كارثي في الـ 18% التي أخطأ فيها (أنتج مخرجات غير قابلة للاستخدام، أو هلوسة، أو خالف قواعد السلامة)، بينما فشل النموذج (ب) بشكل رشيق في الـ 21% الخاصة به، فإن النموذج (ب) هو الخيار الأكثر أماناً للإنتاج. لكن الرقم يقول عكس ذلك.
لهذا السبب تعتبر التصنيفات القائمة على درجة واحدة خطيرة: فهي تضغط أنواعاً عديدة من الأداء في رقم واحد ثم ترتبها، متجاهلة الفروق الدقيقة التي تحدد فعلياً ما إذا كان النموذج مفيداً.
المشكلة السابعة: التكلفة غير المرئية
تقيس كل الاختبارات العامة تقريباً شكلاً من أشكال الجودة أو السرعة. ولا يقيس أي منها تقريباً تكلفة إنجاز المهمة.
هذا غريب، لأن التكلفة غالباً ما تكون العامل الحاسم في الإنتاج. قد ينجح نموذجان في مهمة ما، لكن أحدهما قد يحتاج إلى ثلاث محاولات، ويستهلك أربعة أضعاف السياق، ويكلف خمسة أضعاف. النموذج “الأذكى” (صاحب الدرجة الأعلى في الاختبار) غالباً هو الأغلى في التشغيل.
والأسوأ من ذلك، أن مقياس التكلفة الأكثر شيوعاً، السعر لكل مليون توكن، مضلل بحد ذاته. فهو يتجاهل:
- عدد التوكنات التي يستهلكها النموذج فعلياً في مهمة حقيقية
- عدد المرات التي يحتاج فيها إلى إعادة المحاولة
- مقدار السياق الذي يطلبه
- مقدار المراجعة البشرية التي تتطلبها مخرجاته
الاختبار الذي يقيس الجودة فقط، دون أي إشارة إلى تكلفة تحقيق تلك الجودة، ليس أداة لاتخاذ القرار. إنه أداة تسويقية.
المشكلة الثامنة: الفجوة بين الاختبار والواقع
المشكلة الأخيرة هي الأكثر جوهرية: الاختبار ليس العالم الحقيقي.
النموذج الذي يحصل على 92% في اختبار البرمجة قد يفشل في قاعدة الشيفرة البرمجية الخاصة بك. النموذج الذي يتصدر مهام الاستدلال قد يواجه صعوبة في مجالك المحدد. النموذج الذي يتألق في بيئة اختبار معزولة قد يكون غير موثوق تحت زمن الاستجابة الحقيقي، وحمل الطلبات الفعلي، وظروف الأخطاء الحقيقية.
الاختبارات مفيدة كـ مرشح، فهي تخبرك بالنماذج الموجودة في الحي الصحيح. لكنها عديمة الفائدة كـ مُحدد، فلا يمكنها أن تخبرك بالنموذج الذي سينجح في مهمتك أنت.
كيف تقرأ أي اختبار بشكل نقدي: قائمة تحقق
قبل الوثوق بأي لوحة صدارة، اطرح هذه الأسئلة:
- هل مجموعة الاختبار عامة؟ إذا لم تكن كذلك، فلا يمكنك التحقق من التلوث.
- هل نشر القائمون على الاختبار تدقيقاً للتلوث؟ إذا لم يفعلوا، افترض وجود بعض التلوث.
- هل منهجية التصحيح موثقة؟ إذا لم تكن، فإن الدرجات غير قابلة للتحقق.
- هل يقيس الاستدلال أم الإجابات النهائية فقط؟ إذا كان يقيس الإجابات فقط، فقرصنة الحلول غير مرئية.
- هل ينشر أنماط الفشل، وليس المتوسطات فقط؟ الرقم الواحد يخفي ما إذا كانت حالات الفشل رشيقة أم كارثية.
- هل يقسم النتائج حسب فئة المهمة؟ إذا لم يفعل، فلا يمكنك إعادة ترجيحها لتناسب سير عملك.
- هل يتضمن التكلفة؟ اختبار بدون تكلفة هو نصف قرار فقط.
- هل يمكن إعادة إنتاجه؟ إذا لم تتمكن من إعادة تشغيله، فهو ليس اختباراً، إنه مجرد ادعاء.
ما الذي يجب أن يفعله الاختبار الجيد؟
الاختبار الذي يستحق الثقة يمتلك خمس خصائص:
الشفافية. ينشر مجموعة اختباره، ومصححه، ومنهجيته. يمكن لأي شخص فحص ما يقيسه وكيف.
الحداثة. يغير مهامه بانتظام، حتى لا يحل الحفظ محل القدرة. كما ينشر تدقيقات التلوث.
التقييم على مستوى العملية. يقيس كيف تم الحصول على الإجابة، وليس فقط ما إذا كانت صحيحة، لأن في المسائل المتقدمة، غالباً ما يكون الاثنان غير مرتبطين.
الإبلاغ على مستوى الفئة. ينشر النتائج لكل فئة مهام، وليس كإجمالي واحد فقط، حتى يتمكن المستخدمون من إعادة ترجيح الاختبار لتناسب سير عملهم.
الصلة بالتكلفة. يقيس التكلفة لكل مهمة مكتملة، وليس السعر لكل توكن، بحيث تكون تكلفة تحقيق جودة معينة مرئية إلى جانب الجودة نفسها.
كلمة ختامية
المشاكل الثماني المذكورة أعلاه ليست نظرية. إنها الأسباب التي تجعلنا نبني NeuralRating بالطريقة التي نبنيها بها: نبدأ صغاراً، وننشر منهجيتنا، ونبذل قصارى جهدنا لتجنب الفخاخ التي يصفها هذا المقال. نحن في بداية الطريق، وسنرتكب أخطاء. لكننا نفضل بناء اختبار صغير صادق بشأن حدوده على بناء اختبار ضخم يتظاهر بأنه لا يملك حدوداً.
إذا كنت ترغب في متابعتنا، يمكنك الانضمام إلى قائمة الانتظار في صفحتنا الرئيسية، أو قراءة المزيد عن نهجنا، أو استكشاف المزيد من الرؤى.
الأسئلة الشائعة
ما هو الاختبار (Benchmark) في الذكاء الاصطناعي؟
الاختبار هو مجموعة موحدة من المهام مع طريقة تقييم محددة مسبقاً، تُستخدم لمقارنة أداء نماذج الذكاء الاصطناعي المختلفة. تشمل الأمثلة SWE-bench للبرمجة، وOSWorld لاستخدام الكمبيوتر، وMMLU للمعرفة العامة. تهدف هذه الاختبارات إلى تقديم مقياس موضوعي، لكن تصميمها وطريقة تصحيحها وبياناتها تؤثر جميعها على ما إذا كانت الأرقام تعكس القدرة الحقيقية أم لا.
هل اختبارات الذكاء الاصطناعي موثوقة؟
بعضها موثوق، لكن الكثير منها ليس كذلك. وجدت دراسات حديثة من ستانفورد وNBER وعلي بابا أن ما يصل إلى نصف الدرجات في بعض الاختبارات قد تتأثر بأخطاء في التصحيح، أو تلوث البيانات، أو قرصنة الحلول، أو مهام تكافئ الاختصارات. الاختبار لا يكون موثوقاً إلا بقدر موثوقية منهجيته، ومعظم لوحات الصدارة لا تنشر تفاصيل كافية للتحقق من نتائجها.
ما هو تلوث البيانات في اختبارات الذكاء الاصطناعي؟
يحدث تلوث البيانات عندما تظهر أسئلة الاختبار أو مهامه في بيانات تدريب النموذج. عندئذ يتذكر النموذج الإجابة بدلاً من التفكير فيها، مما يضخم الدرجات. تقدر مراجعة منهجية لعام 2026 أن التضخم يتراوح بين 6% و40%، وتشير إلى أن التلوث الذي يحدث أثناء الضبط الدقيق للتعليمات (Instruction Fine-Tuning) يظل غير قابل للكشف بطرق اليوم.
ما هي قرصنة الحلول (Solution Hacking) في اختبارات الذكاء الاصطناعي؟
قرصنة الحلول هي عندما يصل النموذج إلى الإجابة الصحيحة عبر اختصار غير مشروع، مثل البحث العددي، أو التعداد الشامل، أو التخمين، أو التحقق من إجابة مستدعاة من الذاكرة، دون إجراء الاستدلال الذي صُمم الاختبار لقياسه. وجدت دراسة من علي بابا عام 2026 أن 8% إلى 44% من الإجابات التي حصلت على درجة صحيحة في النماذج المتقدمة كانت في الواقع حلولاً مقرصنة، وأن هذه النسبة ترتفع بشكل حاد مع زيادة صعوبة الاختبار.
ما هي فجوة التعرض (Exposure Wedge) في اختبارات الذكاء الاصطناعي؟
فجوة التعرض هي الفارق بين كيفية ترجيح الاختبار لفئات المهام وكيفية ترجيح سير عملك الخاص لها. تُظهر أبحاث NBER أنه عندما تكون المهام الأكثر استخداماً في عملك هي المهام التي يعالجها النموذج بشكل أسوأ، فإن درجات الاختبار تقلل من الخسارة التي ستواجهها فعلياً. النموذج الذي يبدو موثوقاً في المتوسط قد يفشل في المهام التي يستخدمها فريقك أكثر من غيرها.
كيف أختار نموذج الذكاء الاصطناعي المناسب لمهمتي؟
ابدأ بتحديد معنى 'النجاح' لمهمتك المحددة، وليس بشكل عام. ثم أجرِ اختباراً صغيراً ومضبوطاً باستخدام مطالبات وبيانات تشبه حالة الاستخدام الحقيقية، عبر نموذجين أو ثلاثة. الاختبارات العامة مفيدة كمرشح أولي، لكن يجب ألا تكون قرارك النهائي أبداً. انتبه إلى النتائج على مستوى الفئات، وليس فقط الدرجات الإجمالية.
المصادر
- The Tests That Grade AI May Be Getting It Wrong (Stanford HAI)
- Right Answer, Wrong Method: Shortcut Hacking Misleads the Evaluation of LLM Reasoning
- Artificial Jagged Intelligence: When AI Benchmarks Misstate Deployment Value (NBER)
- Are LLM Benchmarks Already Contaminated? A Systematic Review (GEM 2026)
- Introducing SWE-bench Verified — OpenAI
- OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments